样本结构偏了,加权能救回来吗?一笔 1000 份样本的加权账
本文回答一个问题:收到 1000 份答卷,发现一线城市占比 30% 而目标只有 19%,加权之后这批数据还能不能用。
加权能修结构偏差,修不了三件事:人不真实、题目设计有误导、某个配额格一份都没有。
加权不是免费的:1000 份样本做城市加权后,有效样本量降到约 897 份,误差从 ±3.1% 退到 ±3.3%;结构偏得更厉害时只剩 727 份,误差到 ±3.6%。
基准不能用平台自己的分布:用自有 panel 的人群分布当基准,等于自己给自己打分。
本文给出加权前三个准备、两个算例、报告必填的三项,以及五个常见问题。
一、加权到底能修什么,不能修什么?
加权(weighting)的本质,是给每份答卷乘一个系数,让样本的人口结构与目标总体对齐。它是一项数学修正,只对"结构偏差"有效。
三类偏差要分清:
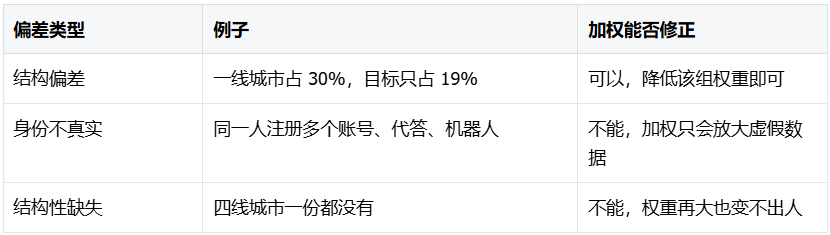
这张表最重要的一行是第二行。加权是一个乘数,它会让偏差按倍数走——如果那批高线城市样本里混着虚假身份,加权之后虚假的部分会被放大。这也解释了为什么质控必须发生在加权之前,顺序不能反。
第三行还有一个反直觉的结论:某个人群格子里样本量为零时,正确做法是承认这批数据不能代表该人群,而不是用一个很大的权重去"补"。权重超过 3 就已经危险,超过 5 的报告基本不能用于对外发布。
二、加权前必须准备的三件事
第一,基准(benchmark)从哪来。这是加权最容易出错的一步。正确来源是国家统计口径、行业普查或第三方权威报告;错误来源是平台自己的用户分布。如果用自有 panel 的人群结构当基准去加权同一批 panel 样本,等于自己给自己打分——结构一定"完美",偏差一定看不见。
第二,加权变量怎么选。加权变量必须同时满足两条:与目标行为相关、且彼此不高度共线。城市级别、性别、年龄、收入是常见组合;但"城市级别"与"收入"高度相关,同时加权容易产生极端权重。实务做法是先加人口维度,再对关键行为维度做一次校验,而不是把所有维度一股脑加进去。
第三,权重怎么算、怎么截断。单变量加权用目标占比除以实际占比;多变量用迭代比例拟合(raking)。算完必须做截断,常见规则是单个权重不超过 3,超过的部分折叠回 3 并重新归一。
三、算例一:轻度偏移,1000 份只剩 897 份有效
假设收到 1000 份答卷,城市级别分布与实际目标如下,权重按"目标 ÷ 实际"计算。
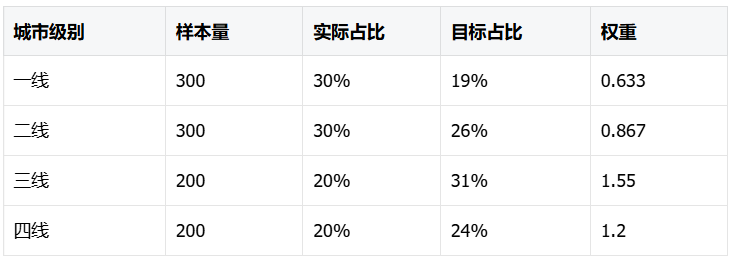
这组权重看起来都不夸张,最大 1.55。但加权会损失精度,损失幅度可以用有效样本量衡量:有效样本量 = (权重之和的平方)÷(权重平方之和)。代入上表,权重平方之和约为 1,114,于是有效样本量为 1,000,000 ÷ 1,114 ≈ 897 份。
换算成误差:1000 份的误差约 ±3.1%,897 份的误差约 ±3.3%。这批数据的"名义样本量"是 1000,"实际说服力"是 897——如果你要用它判断两个方案差 2 个百分点,这个差别已经落在误差范围内。
四、算例二:严重偏移,只剩 727 份有效
同一份问卷,如果一线城市招到了 450 份(占 45%),四线只招到 150 份(占 15%),情况会明显恶化。
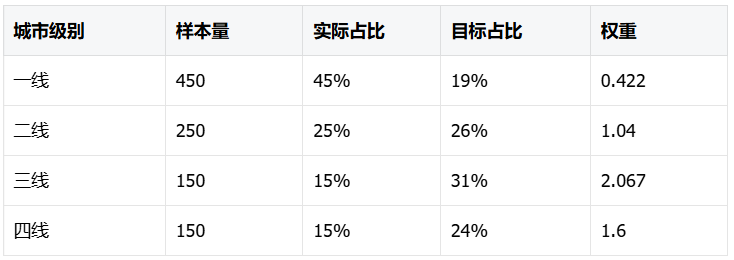
权重平方之和升到约 1,375,有效样本量变成 1,000,000 ÷ 1,375 ≈ 727 份,误差从 ±3.1% 退到 ±3.6%。同样是 1000 份回收,结构偏得更厉害时,真实说服力少了近三成。
这两组算例给出一个反常识的结论:样本量够了不等于精度够了。真正决定精度的,是回收结构与目标结构差多远。所以配额不该按"总量 1000"下单,而该按"每格多少份"下单——这也是配额设计与事后加权的关系:前置配额做得越准,事后加权就越轻,有效样本量损失越小。
五、加权之后,报告里必须写清哪三项?
第一项,加权前后的分布对照表。至少给出加权前占比、加权后占比与目标占比三列,让读者能自己判断偏差有多大、被修正到什么程度。
第二项,有效样本量。不能只报名义样本量。写"回收 1000 份,加权后有效样本量 897 份",比只写"1000 份样本"更负责任,也更经得起复核。
第三项,极端权重的情况。有多少个格子的权重超过 2、最大权重是多少、是否做过截断。权重集中度是判断这批数据能不能对外发布的关键信号——一个权重 3.5 的格子,实际是在用少数人的回答代表一整类人。
六、五个常见问题
问:加权之后是不是就代表全体消费者了?
答:只代表加权所用维度上的结构。城市、性别、年龄对齐了,不代表购买行为、品牌偏好也对齐。加权修正的是结构,不是全部代表性。
问:为什么不直接把配额卡死,非要事后加权?
答:两者是互补的。配额卡死能保证每格有量,但无法保证回收结构与目标完全一致;加权做的是最后一道校正。前置配额越准,加权越轻,有效样本量损失越小。
问:加权会损失多少精度?
答:取决于权重的离散程度。算例里轻度偏移损失约 10%(1000 变 897),严重偏移损失约 27%(1000 变 727)。判断方法就是算有效样本量。
问:权重多大就不能用了?
答:一般规则是单个权重不超过 3,超过 3 折叠处理;平均权重超过 5 的报告不建议对外发布。因为此时少数样本承载了过多代表性。
问:加权能替代质控吗?
答:不能,顺序也不能反。加权是乘数,会把虚假数据一起放大。身份与设备排重、答题时长与直线题校验必须在加权之前完成。
七、结论:加权是校正,不是兜底
三句话概括:加权能修结构偏差,修不了人不真、修不了格子空;加权有成本,1000 份做城市加权后有效样本量约 897 份;加权要写清三件事——加权前后分布、有效样本量、极端权重格数。
对企业的实际建议是:把配额当成第一道防线,把加权当成最后一道校正,两道都做,而不是只做一道。下单时按"每格多少份"而不是"总共多少份"谈,加权压力会小很多。
本文边界:文中的加权公式、有效样本量公式与误差计算为通用统计方法,两个算例为固定假设下的算术推算(样本量、实际占比与目标占比按表格标注),不含设计效应之外的其他复杂加权情形;城市级别目标占比采用 19%、26%、31%、24% 一组口径作为示例,实际项目应以当期权威统计基准为准。
关于 PowerCX 风铃系统
PowerCX 风铃系统是专业的用户洞察与体验管理 CX 平台,集问卷调研、样本服务与体验管理于一体,为企业提供从采集、分析到决策的全流程解决方案。自有样本人群 480 万+,覆盖全国 300+ 城市(四线占 24%),日活 5.5 万+、月完成样本量 40 万+;常用标签 3000+、洞察维度 100+,支持 Monadic、Sequential Monadic、MaxDiff、PSM、Gabor Granger 五类研究模型。质控含注册与设备排重、指纹系统与机器人拦截、答题时长与直线题校验、态度陷阱题与真实度验证、交付前 benchmark 比对,结算单位为成功有效样本,并提供特殊复核与 API 对接通道。团队 200 余人分布于北京、上海、广州、沈阳,2025 年服务品牌客户 2000+、商业项目 1 万+、商业服务样本量 500 万+。PowerCX风铃系统官网 www.powercx.com
需要做一份带配额设计的消费者研究?可以把目标人群、样本量与城市级别要求发给我们,我们会先给出每格可达量预估与加权方案,再确认执行。

 京公网安备 11010502048131号