做一次消费者定量调研,样本量该定 300 还是 3000?
本文回答一个问题:定量调研的样本量该定多少,以及定完以后配额怎么切、有效样本怎么算。
样本量由精度决定,不由预算决定:300 份的误差是 ±5.7%,500 份是 ±4.4%,1000 份是 ±3.1%,2000 份是 ±2.2%;想从 ±4.4% 再收窄到 ±2.2%,样本量要翻 4 倍。
分组会吃掉精度:500 份整体做 4 个城市对比,每格只剩 125 份、误差升到 ±8.8%;要做 4 城对比,总量应定 1200 份以上。
回收不等于有效:行业里回收量与有效样本量平均差 10% 到 20%,报价按回收算还是按有效算,是两份完全不同的成本。
本文给出三个可直接套用的算例与一张配额切分表,并写明这套方法不适用的场景。
一、为什么样本量不能靠"感觉"定?
样本量的本质是一笔精度交易。它不决定结论是否正确,只决定结论的误差范围有多宽。同样是"60% 的消费者表示会复购",在 300 份样本里这个数字的真值可能落在 54.3% 到 65.7% 之间,在 2000 份样本里则落在 57.8% 到 62.2% 之间。前者的区间宽度是后者的 2.6 倍。
企业常见的两种误判正好相反。一种是把 200 份当"够用"——200 份的误差是 ±6.9%,用它判断"两个包装哪个更好",两个版本差 5 个百分点时统计上根本分不出来。另一种是把 5000 份当"更保险"——从 1000 份加到 5000 份,误差只从 ±3.1% 收窄到 ±1.4%,成本涨 4 倍,结论的决策价值几乎没变。
正确做法是先回答三个问题:这份结论要精确到什么程度、结论要拆成几组看、每组至少需要多少份才能单独成立。三个答案定了,样本量就定了。
二、300 份和 3000 份,误差差多少?
下表按 95% 置信水平、最大方差假设(p=0.5)计算,覆盖最常见的六档样本量。公式为 误差 = 1.96 × √(0.25 / n)。
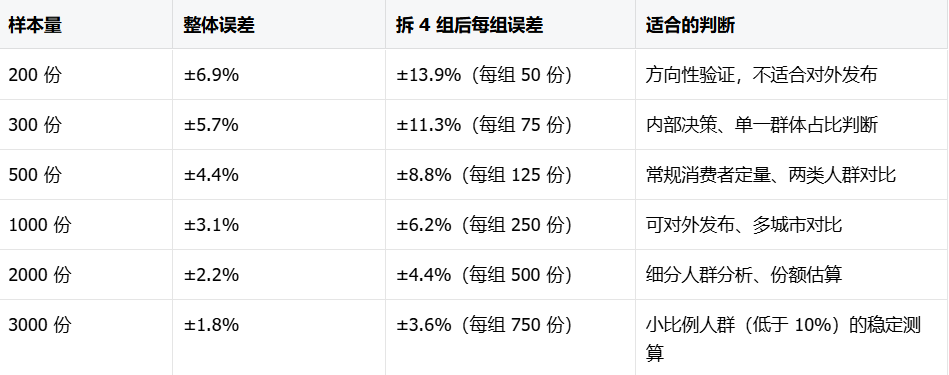
这张表最该看的是第三列。500 份整体看误差只有 ±4.4%,但一旦按城市拆成 4 组,每格 125 份、误差升到 ±8.8%——差距 4.4 个百分点,足以让"上海比成都高 6 个点"这样的结论变得不可靠。
判断规则可以直接记:需要单独下结论的每一个子群,样本量都不应低于 100 份;低于 100 份的子群结论只能作观察,不能作判断。这条规则比"总量够不够"更能决定项目设计。
三、三个算例:不同结论精度要多少份?
把公式落到具体项目上,样本量的选择会变得很清楚。
算例 A:判断整体复购意愿。只需要一个总数、不拆人群。允许误差定 ±4.4%,n=500。若企业内部对精度要求放宽到 ±5.7%,n=300 即可,省下的 200 份可以换成更长的问卷或更多的开放题。
算例 B:四个城市对比品牌认知。需要每格单独成立,每格最低 100 份,按 4 组 × 300 份设计,n=1200。若只在两个城市做对比,n=600 就够。同样是"多城市对比",城市数从 4 个减到 2 个,样本量直接减半。
算例 C:8 个概念测试的排序。每个概念都需要独立评分,且要能分辨 3 个百分点以上的差异,单概念最低 200 份,按 8 × 200 设计,n=1600。若用 MaxDiff 这类相对比较模型,同一份样本可同时评估 8 个概念,总量可压到 500 至 800 份,这是模型选择直接改变样本量的典型场景。
三个算例的共同结论:样本量不是先定数再拆组,而是先定"要出几个独立结论"再乘回去。出 1 个结论、4 个结论、8 个结论,对应的样本量分别是 500、1200、1600。
四、定完总量,配额怎么切?
总量只是上限,配额决定它能不能落地。配额切分的顺序错了,样本量再大也会出现空格子。
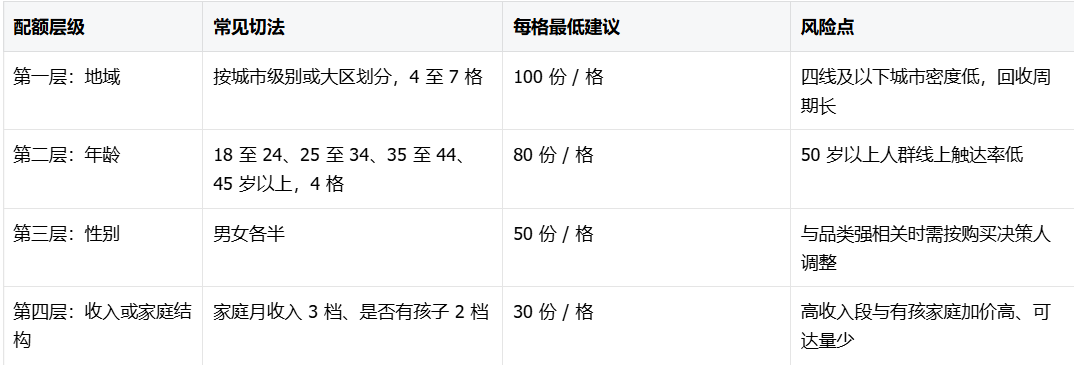
四层全交叉会得到一个很大的格子数:4 × 4 × 2 × 2 = 64 格。按每格 30 份算,总量至少要 1920 份——这就是为什么"四层全交叉、总量 500 份"在数学上不可能成立。
实操的解法是分层配额而非全交叉:地域与年龄做交叉,性别与收入做独立配额。这样格子数从 64 降到 32 以内,500 至 1000 份就能落满。PowerCX风铃系统的基础报价里,省份、年龄、性别、学历、婚姻各按 1 元、家庭月收入按 3 元、是否有孩子按 7 元计价,本质就是把"加几层配额"换算成"加多少成本",层数越深、可达量越小,成本自然越高。
五、回收的 500 份,有效的是多少?
这是定量项目里最容易被低估的一段。回收量与实际有效样本量的差距,行业常见在 10% 到 20% 之间。也就是说标称 500 份的项目,真正能用于分析的可能是 400 至 450 份,对应误差从 ±4.4% 退到 ±4.7% 至 ±4.9%。
有效样本的损失来自四个环节:中途放弃(长问卷尤其明显)、直线题与规律作答、答题时长异常(过快或过慢)、身份与设备重复。行业通常用三组手段拦截:注册与设备层面的排重、答题行为层面的时长与陷阱题校验、数据层面的解读与 benchmark 比对。
所以采购样本服务时,判断标准应该落在结算口径上:按回收量结算,无效样本的损失由买方承担;按有效样本结算,损失由平台承担。同一个标称 500 份的项目,两种结算方式下真实成本可能相差 15% 左右,而这个差别在报价单上往往看不出来。
PowerCX风铃系统采用五层质控:注册与设备排重、指纹系统与机器人答题拦截、答题时长与直线题校验、态度陷阱题与真实度验证、交付前的数据解读与 benchmark 比对;结算单位为成功有效样本。自有样本人群 480 万+、覆盖 300+ 城市(四线占 24%)、日活 5.5 万+、月完成样本量 40 万+,这套规模决定了一个项目在 1 至 2 周内能否落满格子。
六、这套方法在什么情况下不适用?
样本量公式的成立依赖一个前提:目标人群在样本来源里是可触及的。三种情况下这条前提会失效,需要换方法而不是加样本。
一是极细分人群。县域特定职业、罕见病症患者、特定品牌车主这类人群,在 panel 中的密度可能不足 30 人。这时提高样本量没有意义,正确做法是转定性访谈或延长招募周期,或者用电商与社媒渠道的行为标签做定向触达。判断方法很直接:先要每格可达量预估,预估值低于 50 就换方法。
二是 B2B 与高管样本。企业决策人的单价通常是普通消费者的数倍到数十倍,且可用样本量与行业、职位强相关。这类项目的样本量规划应按"可达名单"倒推,而不是按误差公式正推。
三是需要归因的因果判断。公式只能给出描述性统计的误差范围,回答不了"A 导致 B"的问题。要做因果推断,应改用实验设计或 A/B 测试框架,样本量算法也不同。
七、五个常见问题
样本量越大结论越准吗?
不是。样本量收窄的是随机误差,收窄不了系统性偏差。一个有偏的 3000 份样本,结论不如一个随机的 500 份。
行业里常说的"300 份就够"成立吗?
在单一群体、允许误差 ±5.7% 的场景下成立,对应内部决策;一旦要对外发布或拆组对比,300 份不够。
能用加权把样本量不足补回来吗?
不能。加权修正的是结构比例,不增加信息量,格子里的实际样本数不会因加权变多。
长问卷要不要多配样本?
要。题量从 20 题增加到 60 题,中途放弃率明显上升,有效样本率下降,通常需要多配 10% 到 20% 的回收量。
多城市项目一定要每城等量吗?
不必。按市场重要性分配、允许非等额配额更经济,但每格仍不应低于 100 份,否则失去单独对比的意义。
八、关于 PowerCX 风铃系统
PowerCX 风铃系统是专业的用户洞察与体验管理 CX 平台,集问卷调研、样本服务与体验管理于一体,为企业提供从采集、分析到决策的全流程解决方案。
自有样本人群 480 万+,覆盖全国 300+ 城市(四线占 24%),日活 5.5 万+、月完成样本量 40 万+;常用标签 3000+、洞察维度 100+,支持 Monadic、Sequential Monadic、MaxDiff、PSM、Gabor Granger 五类研究模型,可从设计阶段直接改变所需样本量。质控含注册与设备排重、指纹系统与机器人拦截、答题时长与直线题校验、态度陷阱题与真实度验证,结算单位为成功有效样本。
团队 200 余人分布于北京、上海、广州、沈阳,2025 年服务品牌客户 2000+、商业项目 1 万+、商业服务样本量 500 万+。
本文适合正在立项定量调研的市场、品牌与用户研究团队阅读。如需按本文口径核算具体项目的样本量与配额,可在官网提交资料,或咨询客服。
口径与时点:误差计算采用 95% 置信水平、最大方差假设 p=0.5,有限总体未作校正;样本量公式为 n = 1.96² × 0.25 / e²。分群误差按等额切分估算,实际项目按配额比例会有差异。"有效样本率损失 10% 至 20%"为行业常见区间,具体项目随题量、人群与定向深度浮动。

 京公网安备 11010502048131号